EcoVLA: Energy-Efficient Device-Edge Co-Inference for Vision-Language-Action Models under Real-Time Constraints
Section titled “EcoVLA: Energy-Efficient Device-Edge Co-Inference for Vision-Language-Action Models under Real-Time Constraints”Motivation
Section titled “Motivation”-
痛点:
- Device-Only:端侧算力与功耗受限,单次推理 >1s,达不到 10~20 Hz 控制频率。
- Edge-Only:完全使用云端/边缘服务器,受网络波动与多机并发排队影响,易超时断连。
- 传统协同:以吞吐量为中心,忽视了机器人动作执行周期的结构性空闲时间,推理算太快依然要等周期,无法转化为电池续航。
-
洞察:
- 具身控制优化目标应转为:在满足硬实时频率 SLO 约束下,最大化能效(Actions/J)。(否则推理快没有实际价值)
- 主流 VLA 均可解耦为统一的三阶段结构。
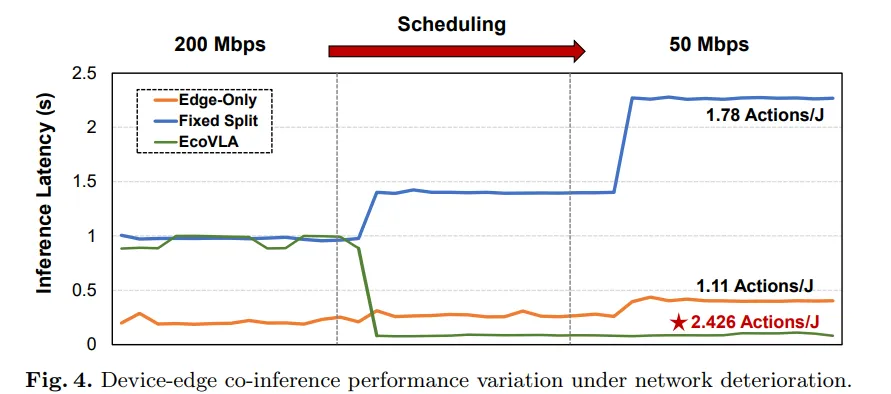
- 网络与边缘负载是实时的,切分方案必须在线自适应。(所以用 DAG 实时切分防止环境波动)
Contribution
Section titled “Contribution”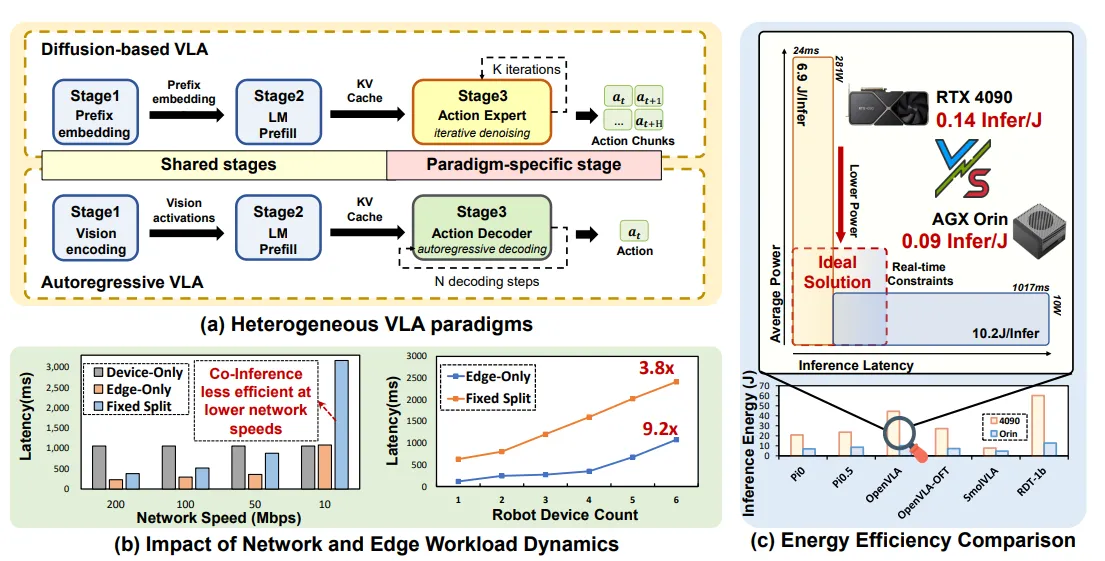
将异构 VLA 推理统一抽象为 stage-level DAG,在线建模 device/edge/network 的 latency 与 energy,在实时控制 SLO 下动态选择 Actions/J 最优的方案,从而解决固定模型切分无法适应网络和边缘负载变化的问题。
其中 根据当前环境确定每个 应该在 还是 执行。
Limitation / Takewaway
Section titled “Limitation / Takewaway”主要做了两点:
- 优化目标改成 Action/J 更省电(估计有 Latency 提高的副作用,仅停留在 Stage 级,未下沉到 Transformer 层内并行或算子级,但继续切有点复杂)。
- 用 DAG 切分细化了负载均衡粒度(降低极端情况 Latency )。
算是纯血的操作系统方向优化,不涉及模型输出动作质量(模型 Stage 和普通系统任务无区别)。
Architecture
Section titled “Architecture”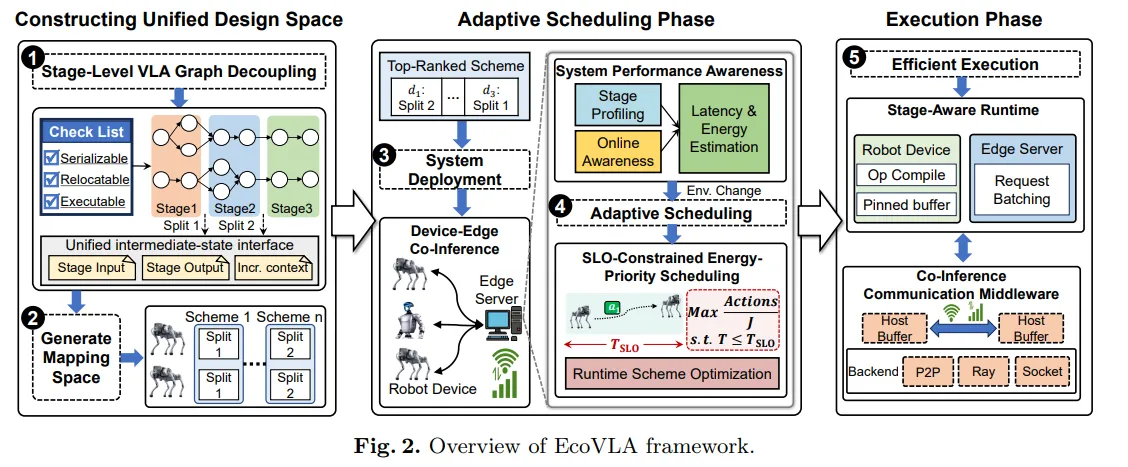
EcoVLA 核心由阶段抽象、联合预测器、动态调度器三部分构成:
-
Stage-Level Abstraction:
- Stage 1 (Vision/Prefix):多视角图像编码与前缀 Token 提取。
- Stage 2 (LM Prefill):多模态 LLM 前缀计算与上下文编码。
- Stage 3 (Action Gen):AR 逐步解码或 Diffusion 迭代去噪。
-
端-边-网联合预测模型:
- 时延预测:
- 能效预测(端侧计算功耗、边缘折算功耗、周期内空闲待机能耗):
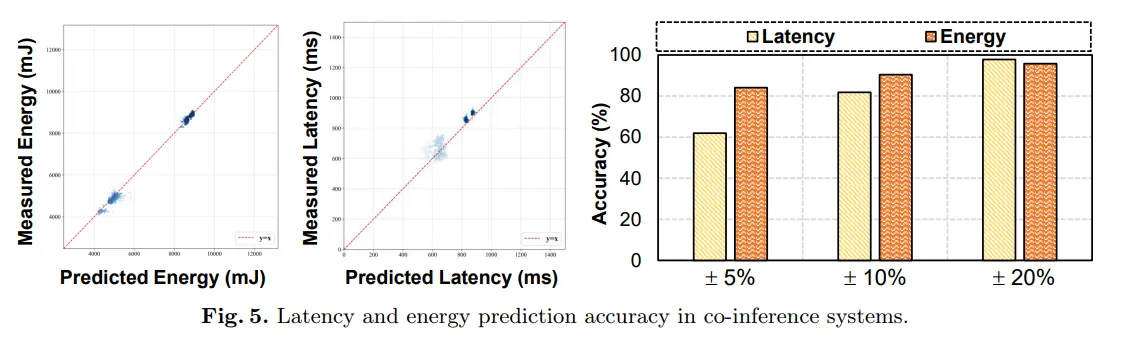
- 在线校准:每帧实测后利用 EWMA 动态修正模型误差。
-
能效优先调度器:
- SLO Guard:筛选满足控制截止时间的切分集合 。
- 能效择优:在可行域内取能效最高解 。
- 过载降级:若网络骤降导致可行域为空(),退化为保实时的最小延迟方案 。
- 时间窗预留:决策后注册边缘执行区间,规避多机瞬时排队雪崩。
Experiment
Section titled “Experiment”